(1) Takara bio.에서 판매하는 Illumina 분석용 NGS library kit는 어떻게 구성되나요?
Adapter는 NGS 장비가 인식할 수 있는 고유한 염기서열을 가진 oligonucleotide로써, library 제작 방식에 따라, ligation 혹은 PCR 등의 방식으로 분석하고자 하는 DNA에 부착된다.
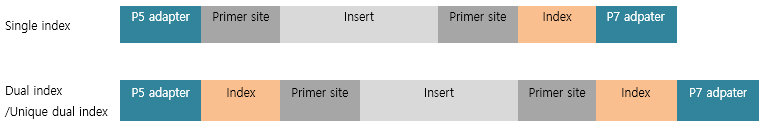
Index 혹은 barcode는 각 샘플별로 부여되는 임의의 서열로, 이를 통해 분석 과정에서 각 reads가 어느 샘플에서 유래되었는지를 확인하게 된다. Single/dual/unique dual index 중 원하는 것으로 변경할 수 있으며, 어떤 종류를 선택하는 지에 따라 분석 정확도가 달라질 수 있다.
Single index를 포함하는 경우, P7 앞에만 index가 위치하게 되며, dual index 혹은 unique dual index를 포함하는 경우 P5 뒤와 P7 앞에 각각의 index가 위치한다.
How does dual indexing work?
Single-read flow cells로 분석하는 경우
-> 16 additional cycles of sequencing: 8 cycles for the Index 1 (i7) Read and 8 cycles for the Index 2 (i5) Read.
Paired-end flow cells로 분석하는 경우
-> 23 additional cycles of sequencing: 8 cycles for the Index 1 (i7) Read, 8 cycles for the Index 2 (i5) Read, and 7 nonimaging, chemistry-only cycles at the beginning of the i5 Read.
(3) Dual index를 사용한 library가 single index를 이용한 library에 비해 좋은 점은 무엇인가요?
What are the advantages of using dual- versus single-indexed libraries?
- Identifier 추가 도입으로 index hopping 등을 방지할 수 있어, 샘플 간의 구별 정확도 향상
- Flow cell의 lane 별로 multiplexing 할 수 있는 샘플 수가 많아, 더 많은 샘플을 한번에 분석
- Index 1 read (i7), index 2 read (i5)의 추가된 두 reads를 이용해 분석 진행
(4) Index hopping은 무엇인가요?
What is index hopping?
Index hopping (혹은 index switching)은 sequencing reads에 예기치 않은 index가 잘못 배치되는 것으로, 후속 분석에서 misalignment나 부정확한 결과로 이어질 수 있다. Unique dual index (UDI)를 적용하게 되면 이러한 index hopping 현상을 최소화 할 수 있어, 높은 민감도가 요구되는 실험에서는 UDI를 사용할 것을 권장한다.
(5) Index crosstalk 혹은 “sample bleeding” 문제를 어떻게 해결할 수 있나요?
How can I mitigate index crosstalk or "sample bleeding" issues?
- Library 제작 시, single index 보다는 dual index를 사용한다.
- Index의 adjacent cluster 수가 줄어들도록, PhiX spike-in의 비율을 높인다.
- Cluster density를 줄이기 위해 한번에 분석하는 library양을 줄인다.
(6) Single-end reads와 paired-end reads의 차이는 무엇인가요?
What is the difference between single and paired-end reads?
Single-end reads로 분석하는 경우
-> 핵산의 한쪽 끝에서만 원하는 길이로 서열을 읽어낸다 (e.g., 50-, 75-, 혹은 100- bp reads)
Paired-end reads로 분석하는 경우
-> 핵산의 한쪽 끝에서 원하는 길이로 서열을 읽어낸 후, 반대의 핵산 끝에서도 반복한다.
-> Insertion, deletion, genomic rearrangements를 검출할 수 있다.
(7) Single-indexed library로 paired-end sequencing을 진행할 수 있나요?
Can I do paired-end sequencing with single-indexed libraries?
Single-indexed library로 paired-end sequencing을 진행할 수 있다. Sequencing을 진행하는데 있어, single 이든 pair 이든 어떤 index가 사용되었는 지에 따라 달라지는 것이 없다. 모든 library에서 sequencing은 Read Primer 1이나 2를 사용하여 진행할 수 있으며, dual-indexed kit를 이용했을 때에도 single reads를 사용할 수 있다.
(8) 양 말단에 index를 포함하고 있는 경우에도 single-read로 분석이 가능한가요?
Can I perform single-read runs and still obtain both index sequences?
양 말단에 index를 포함하고 있는 경우에도 single-read로 분석이 가능하다. 이 경우, 분석을 진행하고자 하는 flow cell에서 권장되는 실험 방식을 따른다 (e.g., single-read 혹은 paired-end). 만약, single-read를 사용하는 flow cell로 양 말단의 index reads 서열을 모두 읽고자 하는 경우, TruSeq® Dual Index Sequencing Primer Box, Single-Read (Illumina, Cat # FC-121-1003)을 사용해야 한다.
(9) Multiplexing 샘플을 분석할 때 무엇을 고려해야하나요?
What should I consider when multiplexing samples?
어떤 샘플이든 multiplex로 분석할 수 있으나, 최상의 결과를 얻기 위해서는 아래 사항을 따를 것을 권장한다.
- 각 샘플 별 fragment length는 꼭 일치해야 한다. 다른 길이의 library를 하나의 flow cell에 섞어 분석하는 경우, 샘플 별 coverage가 일정하지 않아 다른 효율을 나타낼 수 있다.
- 하나의 flow cell에서 분석하는 샘플은 모두 같은 barcoding 방법으로 library를 구성해야 한다 (e.g., single-indexed 샘플과 dual-indexed 샘플을 섞어서 분석하지 않는다).
- 하나의 flow cell에서 분석하는 샘플은 모두 같은 종류의 barcode로 library를 구성해야 한다 (e.g., TruSeq® barcoded 샘플과 Nextera® barcoded 샘플을 섞어서 분석하지 않는다).
- Illumina® library prep kit를 사용하지 않는 경우, Illumina® index와 동일한 서열을 사용하거나 이미 알고 있는 서열의 index를 custom barcode로 사용한다.
(10) Index를 pooling할 때 지켜야하는 사항은 무엇인가요?
What guidelines should I follow when pooling indexes?
Illumina®사의 HiSeq® 혹은 MiSeq® 기기는 A와 C 염기를 읽기 위해 red laser/LED를 사용하고, G와 T 염기를 읽기 위해 green laser/LED를 이용한다. 각 cycle에서 red, green channel 모두 적절하게 읽혀야 하며, 만일 color balance가 맞지 않는 경우, index read의 서열이 분석되지 않을 수 있다.
Illumina®사의 NovaSeq™, NextSeq®, MiniSeq® 기기는 two-color를 이용해 분석하게 되며, 처음의 두 cycle 내에서 index가 GC서열을 포함하지 않는 경우 분석이 개시되지 않기 때문에 적절한 index를 조합해야 한다.